Scaling Laws For Sparse Retrieval と言えるのか実験してみた
はじめに
この記事は情報検索・検索技術 Advent Calendar 2024 の 23 日目の記事です。.
Scaling Laws For Dense Retrieval に論文を読んで、これを Sparse Retrieval で試すとどうなるんだろうと思ったので実験してみた記録。いわゆるやってみたブログです。
どういう論文?
- モデルの性能評価するには既存の評価メトリクスに課題があるので新しいメトリクスを提案
- dense retrivalモデルが精度とモデルサイズ、データサイズに冪乗則に従うことが観測された
- スケーリング則により予算配分の予測ができる。
- スケーリング則により異なるアノテーション手法の有効性の評価ができる
既存の評価メトリクスの課題は?
- 検索タスクの従来の性能指標(NDCGなど)はカットオフパラメータkに依存しているため連続的ではない
- 正のパッセージが上位kに含まれた場合のみ指標に寄与する。仮にK+1の順位にあっても寄与しない
- mrr@k, ndcg@kランキングメトリクスはパッセージの順序が変化しない限り変化しないのでモデル出力の変化に敏感ではない
提案手法
- モデルの全体的な検索能力を敏感に反映する連続的なメトリクスとしてconstrastive entropyを提案
- contrastive entropyはIRで使われるメトリクス(MAPやnDCG, Recall)と相関する

実験
実験方法
- 日本語と英語のデータとモデルで実験
- モデルサイズ、データサイズ、アノテーション方法を変えて256のnegative passageをランダムに選択して、contrastive entropyを算出
- どういうネガティブサンプリングを行うかは検索精度に大きく影響するが、この論文ではサンプリング戦略に焦点をあてずランダムサンプリング選択
利用モデル
事前学習タスクがdense retrival modelのパフォーマンスに強く影響することが先行研究でわかっているので、この影響を小さくするため同じ構成でパラメータサイズが異なるだけの一連のモデルを選んでいる。
英語: BERTシリーズ
- BERT-TinyからBERT-Base
- BERT variantも使ったぽいが具体的になにを使ったか不明
中国語: ERNIEシリーズ
- 出力次元を768にした
利用データ
英語: MSMARCO
中国語: T2Ranking
結果
Modelサイズの増加に合わせて精度向上した。

Modelサイズがスケーリング則にfitする

Dataサイズがスケーリング則にfitする

sparse modelでも同様なのか試してみる
実験
splade++で実施
- [From Distillation to Hard Negative Sampling: Making Sparse Neural IR Models More Effective https://arxiv.org/abs/2205.04733] - naverのspladeリポジトリで公開されている実装で1GPUの設定を利用
- パラメータはすべて同じものにしてみる
データはMSMarcoのみ
ModelはBERTを利用
- prajjwal1/bert-tiny
- prajjwal1/bert-mini
- prajjwal1/bert-small
- prajjwal1/bert-medium
- google-bert/bert-base-uncased
学習したものはこちらで公開
結果
ランキングメトリクスは微妙(nDCGはメモっておくの忘れた

constrastive entropyは差がなし

base-uncasedはおなじパラメータではうまく学習ができていなさそう...
text: I bought an apple stock.

----ryook/splade-bert-tiny-monogpu----
token数: 32
{'apple': 2.515625, 'stock': 2.216796875, 'bought': 2.109375, 'i': 1.8486328125, 'buy': 1.7177734375, 'purchased': 1.4814453125, 'acquired': 1.4267578125, 'sold': 1.1201171875, 'apples': 0.99658203125, 'em': 0.99462890625, 'purchase': 0.92578125, 'an': 0.845703125, 'oak': 0.7646484375, 'chips': 0.49853515625, 'bean': 0.455078125, 'price': 0.454345703125, 'orchard': 0.38037109375, 'when': 0.37158203125, 'inherited': 0.317626953125, 'owned': 0.312744140625, '/': 0.29541015625, 'business': 0.290283203125, 'products': 0.2293701171875, 'we': 0.1800537109375, 'gum': 0.1668701171875, 'butter': 0.141845703125, 'company': 0.1307373046875, 'gr': 0.10906982421875, 'was': 0.08062744140625, 'pulled': 0.07159423828125, 'maybe': 0.0307769775390625, 'originally': 0.027923583984375}

----ryook/splade-bert-small-monogpu----
token数: 32
{'apple': 2.529296875, 'stock': 2.349609375, 'bought': 2.025390625, 'apples': 1.4853515625, 'purchase': 1.1318359375, 'buy': 1.0478515625, 'founded': 1.005859375, 'owned': 0.998046875, 'sold': 0.9423828125, 'owner': 0.80908203125, 'inherited': 0.7900390625, 'i': 0.78466796875, 'purchased': 0.626953125, 'adam': 0.607421875, 'orange': 0.55078125, 'sell': 0.50341796875, 'built': 0.48779296875, 'chip': 0.481201171875, 'acquired': 0.425537109375, 'mint': 0.40673828125, 'tree': 0.356201171875, 'company': 0.344482421875, 'pear': 0.325439453125, 'early': 0.2939453125, 'stolen': 0.265869140625, 'import': 0.208984375, 'walnut': 0.1961669921875, 'pen': 0.1767578125, 'pie': 0.13330078125, 'dairy': 0.08782958984375, 'edition': 0.07159423828125, 'wood': 0.0212554931640625}

----ryook/splade-bert-mini-monogpu----
token数: 32
{'apple': 2.806640625, 'stock': 2.44921875, 'bought': 2.1796875, 'apples': 1.8427734375, 'buy': 1.6025390625, 'owned': 1.466796875, 'purchase': 1.3837890625, 'stocks': 1.2734375, 'app': 0.748046875, 'an': 0.70849609375, 'company': 0.68701171875, 'invented': 0.6806640625, 'i': 0.64111328125, 'inherited': 0.63232421875, 'inventor': 0.62255859375, 'sold': 0.5673828125, '##stock': 0.49755859375, 'picked': 0.493408203125, 'owner': 0.45751953125, 'scott': 0.409423828125, 'purchased': 0.375732421875, 'corporation': 0.282958984375, 'pear': 0.28076171875, 'because': 0.27490234375, 'acquired': 0.26904296875, 'investment': 0.25390625, 'want': 0.1527099609375, 'harrison': 0.128173828125, 'jacobs': 0.1072998046875, 'business': 0.049530029296875, 'straw': 0.038330078125, 'inventory': 0.0164642333984375}

----ryook/splade-bert-medium-monogpu----
token数: 38
{'apple': 2.7890625, 'stock': 2.2890625, 'apples': 1.7548828125, 'purchased': 1.5087890625, 'buy': 1.447265625, 'investors': 1.4462890625, 'bought': 1.3095703125, 'nan': 1.1025390625, 'purchase': 0.97119140625, 'owned': 0.93505859375, 'company': 0.75732421875, 'stocks': 0.6025390625, 'brand': 0.58935546875, 'buying': 0.5234375, 'application': 0.51806640625, 'sold': 0.5146484375, 'an': 0.47705078125, 'sell': 0.419677734375, 'share': 0.4189453125, 'candy': 0.37646484375, 'i': 0.352783203125, 'acquired': 0.303466796875, 'price': 0.227783203125, 'pick': 0.203369140625, 'hold': 0.18896484375, 'discovered': 0.180908203125, 'owner': 0.1668701171875, 'model': 0.165283203125, 'alice': 0.1195068359375, 'jewelry': 0.10382080078125, 'picked': 0.10028076171875, 'author': 0.09759521484375, 'companies': 0.08154296875, 'loan': 0.06610107421875, 'gifts': 0.06427001953125, 'business': 0.042083740234375, 'ama': 0.023162841796875, 'finance': 0.01068115234375}

----ryook/splade-bert-base-uncased-monogpu----
10
{'big': 1.6337890625, 'biggest': 1.625, 'ad': 1.0537109375, 'height': 1.0458984375, 'general': 0.900390625, 'a': 0.88916015625, 'man': 0.86083984375, 'the': 0.62451171875, 'men': 0.50927734375, 'ca': 0.4599609375}
結論
- 今回の実験だとスケーリング則うんぬんの前にメトリクスがほとんど同じだったり、そもそも学習に失敗していそう
- Spladeは綺麗なsparse tokenを出すのにパラメータを調整する必要があり、割と崩れやすい
- Spladeを使う場合パラメータの調整が必要だけど、パラメータがモデルサイズごとに違う場合、同じ条件での比較するにはどうすればいいんだろう...
IR reading 2024春で紹介しようと考えていたSparseモデルの論文
背景
IR reading 2024春で発表予定だった論文の紹介。
都合により発表できなくなったのでここで供養する。 数式等細かいところまでまとめる時間なかったので読んでたときのメモ+αくらいの内容。
どっちかにしようかなと思っていたけど、OneSparseのほうは発表があるっぽい。
Improved Learned Sparse Retrieval with Corpus-Specific Vocabularies(ECIR2024) Puxuan Yu, Antonio Mallia
Sparseな学習済検索システムのefficiency と effectivenessを改善するために、コーパス固有のVocabularyを活用するという研究。
Corpus-Specific Vocabularies (CSV)というのは、ターゲットとするコーパスを用いてBERTで事前学習したものを指す。 この論文だとBERTの標準的な語彙サイズである3万語よりも多い、10万語,30万語という大きいサイズを検討している。
このCSVをつかうことで effectiveness と efficiency を改善できるらしい。
effectivenessの改善
そもそも標準的なBERTは事前学習に、BooksCorpus(800Mワード)やEnglish Wikipedia(2,500Mワード)のデータセットを用いられるが、これが検索対象のコーパスと語彙が一致するわけではない。 一方で、検索対象のコーパスを使って事前学習を行うことでVocabularyに含まれる語彙が検索対象のコーパスに含まれるもののみになる(この論文でいうCorpus-Specific Vocabularies)。
検索クエリで使われる語彙に対しては、標準的なBERTのVocabulariesよりも検索対象のコーパスで事前学習したCorpus-Specific Vocabulariesのほうがカバレッジが高いと考えられる。
ちなみに、Abstractでは12% qualityが上がったと書いてあったが、どの実験の話をしているのかわからなかった。 一番近いのはこの実験結果
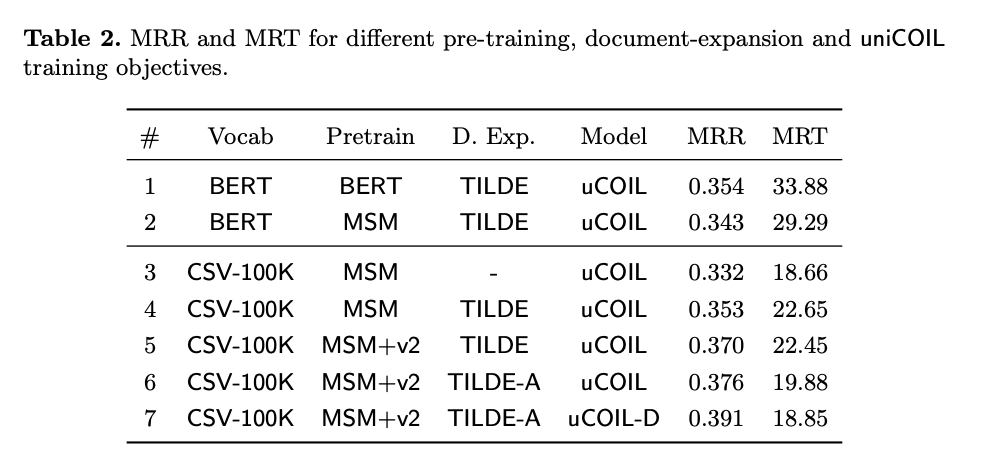
efficiencyの改善
CSVを使うとeffectivenessが向上するのは予想通りな感じはするが、efficiencyも改善するらしい。
語彙数が増えるほどクエリのトークン数が減り、また、pasageの長さ、クエリのポスティングリスト、MRT(mean retrieval time)が減少する。らしい。
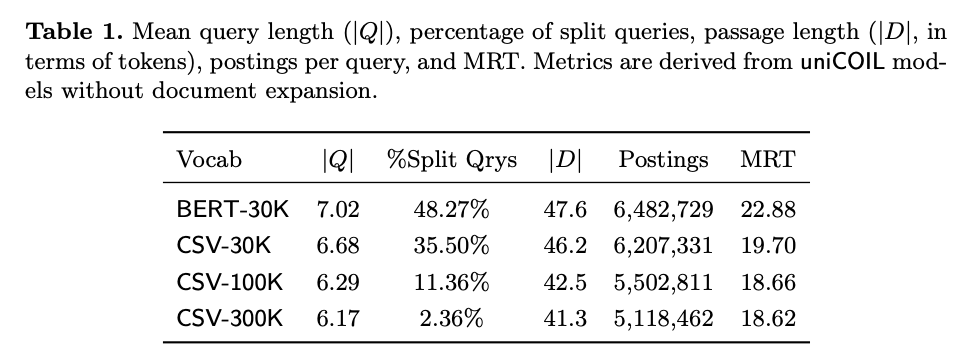
またlatencyも向上する。 これはuniCOILとSPLADEで原因が異なるよう。
以下は私の理解なので正しいか怪しいところ。
- uniCOILの場合、CSVを用いると、転置インデックス内のポスティングリストの長さが短縮されるため、クエリ処理に必要な時間が短縮され、レイテンシが短縮される。
- SPLADEの場合、effectivenessとefficiencyのバランスをとるためにおこなれている?SPLADEモデルで使用されるFLOPSスパース正則化の効果が語彙サイズが大きくなるほど高まるからなのだろうか。 そうだとすると、CSVがというより語彙サイズの問題のようにも思える。
デメリット
一見よさそうに見えるがデメリットはもちろんある。
- 事前学習にコストかかる
- 大規模なコーパスが必要
CSVは独自のコーパスを使ってBERTの事前学習を行うため、単純に時間とコストがかかる。 2に関して、ベースラインを作るために、30kの語彙を持つBERT-largeで事前学習する実験をしたがMSMARCOコーパスだと小さすぎたとのことで、事前学習にはそれなりに大きなコーパスが必要になるよう。
OneSparse: A Unified System for Multi-index Vector Search (WWW '24) Chen , 他著者多数
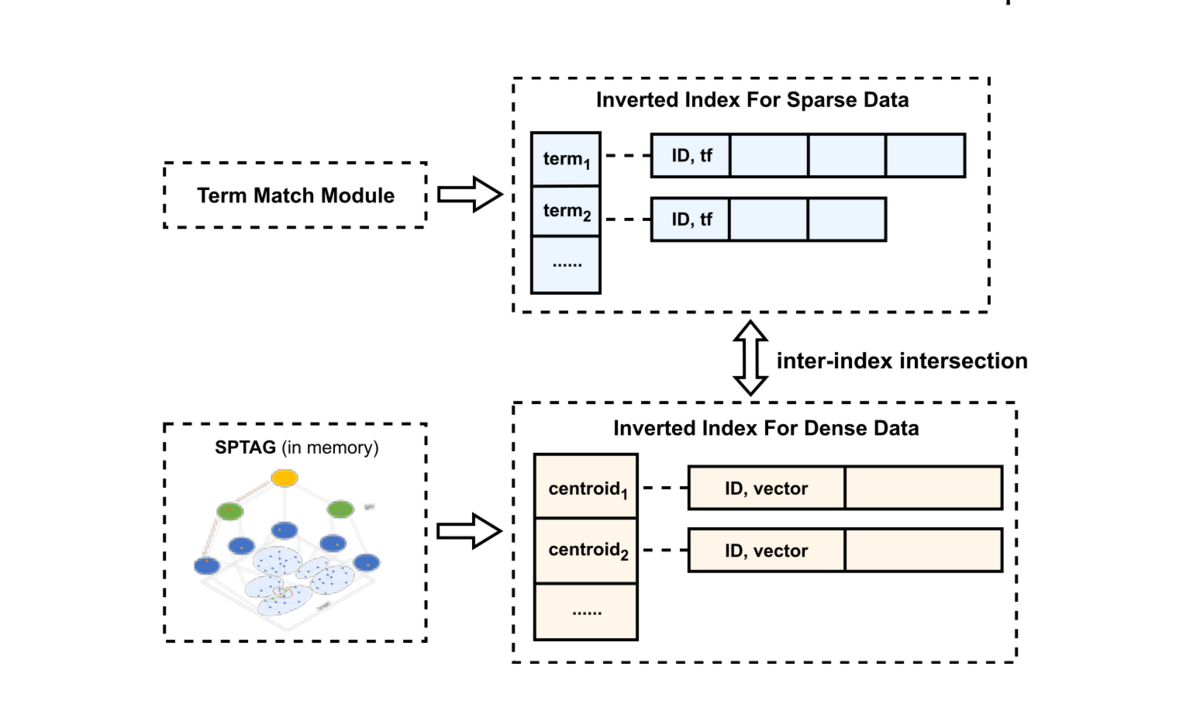
タイトル通り複数のvector searchのindexを統合するシステムOneSparseの提案。 ここでいう複数のvector searchのindex(Multi-index Vector Search)はsparseとdenseの二つのモデルを別のindexして検索するようなシステムを指す。
従来のシステムでは、例えばsparseとdenseの二つのモデルを別のindexしていた場合、それぞれのindexからtopKをそれぞれ検索した後に統合する仕組になっている。
この仕組はいくつか課題があって、
- それぞれのindexで適切なkの設定が難しい
- 最初にそれぞれスコアを行うため、結果的に最終的に使わない結果も計算したり低品質な結果が混じったりする
Onesparseはこのあたりの課題を解決しつつ、検索精度の維持しつつ検索速度を向上させる。
Onesparseの手法
OneSparseでは、従来のそれぞれのtopkの計算を待ってから結合していくのではなく、そもそも計算中に不要なドキュメントを排除していく手法をとる。
そのためのアイディアとして、dense vectorをSPANNアルゴリズムでクラスタリングする。各クラスタは属するvectorとidのペアを持ち、このクラスタをポスティングリスト(SPANNポスティングリスト)として扱うことで、 従来のポスティングリストの走査時の性質をそのまま使えるようにしている。
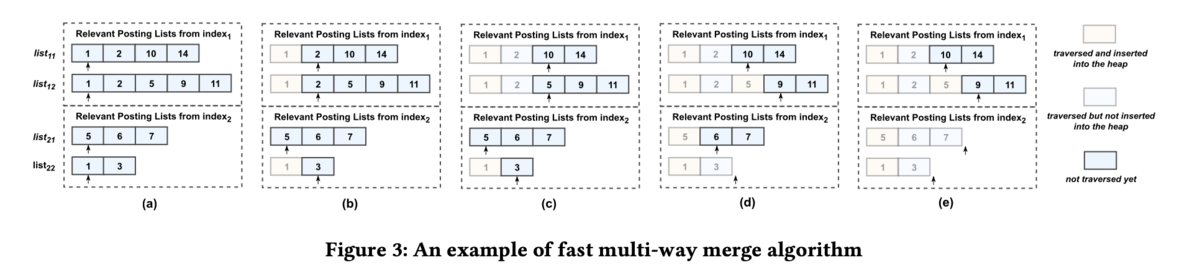
この性質を使ってfast multi-way merge algorithmが提案されている。 このアルゴリズムは、転置インデックスが転置リストの走査中にインデックスの積集合/和集合を実行できるという特徴に基づいて処理を効率化するもので、すべてのindexに含まれるドキュメントのみをスコア計算する。
従来の方法だとすべてのインデックスが TopK検索を完了するまで待つが、複数のインデックスを同時にトラバースすることでそもそも両方のindexに含まれないドキュメントはskipしてそもそもスコア計算をしないことで計算量をかなり節約できる。 これによって、ANN 距離と BM25 スコア計算を実行する前に、平均して 99% 以上の低品質の候補をフィルタリングできるらしい。
さらに計算量を減らすアイディアとして、SPANNポスティングリストの圧縮も提案されている。 属するvectorの重心をそのクラスタのembeddingにすることでより効率的にスコア計算が可能になり、検索時はクエリがどのクラスタに近いかだけを計算するようにする。
したがってOneSparseでは、すべてのindexに含まれるdocumentのみに対してスコア計算を行い、さらにANN距離の計算はそのポスティングリストひとつに対してのみ実施することで、パフォーマンスの改善を実現している。
結果として、Bing Web 検索で品質を担保して、レイテンシーが5倍になったらしい。
感想
論文ではElasticserachでの実現方法も記載されており、実現しやすそうな気もしたが、以下の二つが気になっている。
- 検索時のクエリとクラスタとの距離計算
論文中では、最初にin-memoryのSPTAGインデックスを利用して、いくつかの最も近いクラスタを特定する。とあるが、in-memoryのSPTAGインデックス構築をどうやるのか、どれくらいのスペックが必要なのかという点が実用を考えると気になるポイントだった。
- fast multi-way merge algorithmの最悪ケースの精度
全てのindexに含まれるドキュメントのみスコア計算するが、もしドキュメントがかぶらなかったらかなり低いランクのドキュメントばかりになるのでは?と思ったが、そのあたりどう対処するのかよくわからなかった。
クラスタ構成のQdrantでsnapshotを作成/復元する
クラスタ構成のQdrantでsnapshotを復元する際のめも
前提
[重要] Qdrantはクラスタ構成であること。
面倒なことにQdrantは1ノードの構成なのかクラスタ構成なのかでsnapshotの復元方法が異なる。
環境
手順
collection作成~point追加
これを使ってamazon_reviewというcollectionを作成 HuggingFaceのデータセットからamazonのレビューを取得して5000件ほどembeddingして追加。
data downloadとかembeddingに少し時間かかるので、自分で適当なcollectionとpointを作成したほうが早い。
snapshot作成
POST collections/amazon_review/snapshots
デフォルトでsnapshotのディレクトリは./snapshotsになっている。
コンテナの中に入って確認したらこんな感じ。
root@3396583d4622:/qdrant# ls -lh snapshots/amazon_review/
total 73M
-rw-r--r-- 1 root root 73M Aug 26 07:52 amazon_review-8556042130106098-2023-08-26-07-52-28.snapshot
snapshotが作成されていることが確認できたので、collectionを削除。
DELETE collections/amazon_review
snapshot復元
snapshotの復元方法は二つあるがクラスタ構成の場合はAPIを使って復元する方法一択になる。
まずcollectionを作成する。
PUT collections/amazon_review
{
    "vectors": {
      "size": 768,
      "distance": "Cosine"
    }
}
次にsnapshotを復元する。
PUT /collections/amazon_review/snapshots/recover
{
  "location": "http://qdrant_primary:6333/collections/amazon_review/snapshots/amazon_review-8556042130106098-2023-08-26-07-32-20.snapshot"
}
ポイントはsnapshot復元前にcollectionを作成しておくこと。そして作成時にvectorsのsizeはsnapshotのものに揃えておくこと。 ここが間違っているとエラーになる。
collectionを作成せずにrecoverすると以下のエラーが返ってくる。
{
  "error": "Wrong input: Failed to download snapshot from http://qdrant_primary:6333/collections/amazon_review/snapshots/amazon_review-8556042130106098-2023-08-26-07-52-28.snapshot: status - 404 Not Found"
}
download snapshot でエラーが発生してstatus 404なのでlocationが間違っているように見えるが、単純にcollectionがないだけである。
そしてややこしいことに、本当にsnapshotが存在しない場合も
PUT /collections/amazon_review/snapshots/recover
{
  "location": "http://qdrant_primary:6333/collections/amazon_review/snapshots/hogehogehoge.snapshot"
}
同様のエラーが返ってくる...
{
  "error": "Wrong input: Failed to download snapshot from http://qdrant_primary:6333/collections/amazon_review/snapshots/hogehogehoge.snapshot: status - 404 Not Found"
}
collectionがないことに気づかず無駄な時間を使ったのでこのエラーが出た場合は注意.
